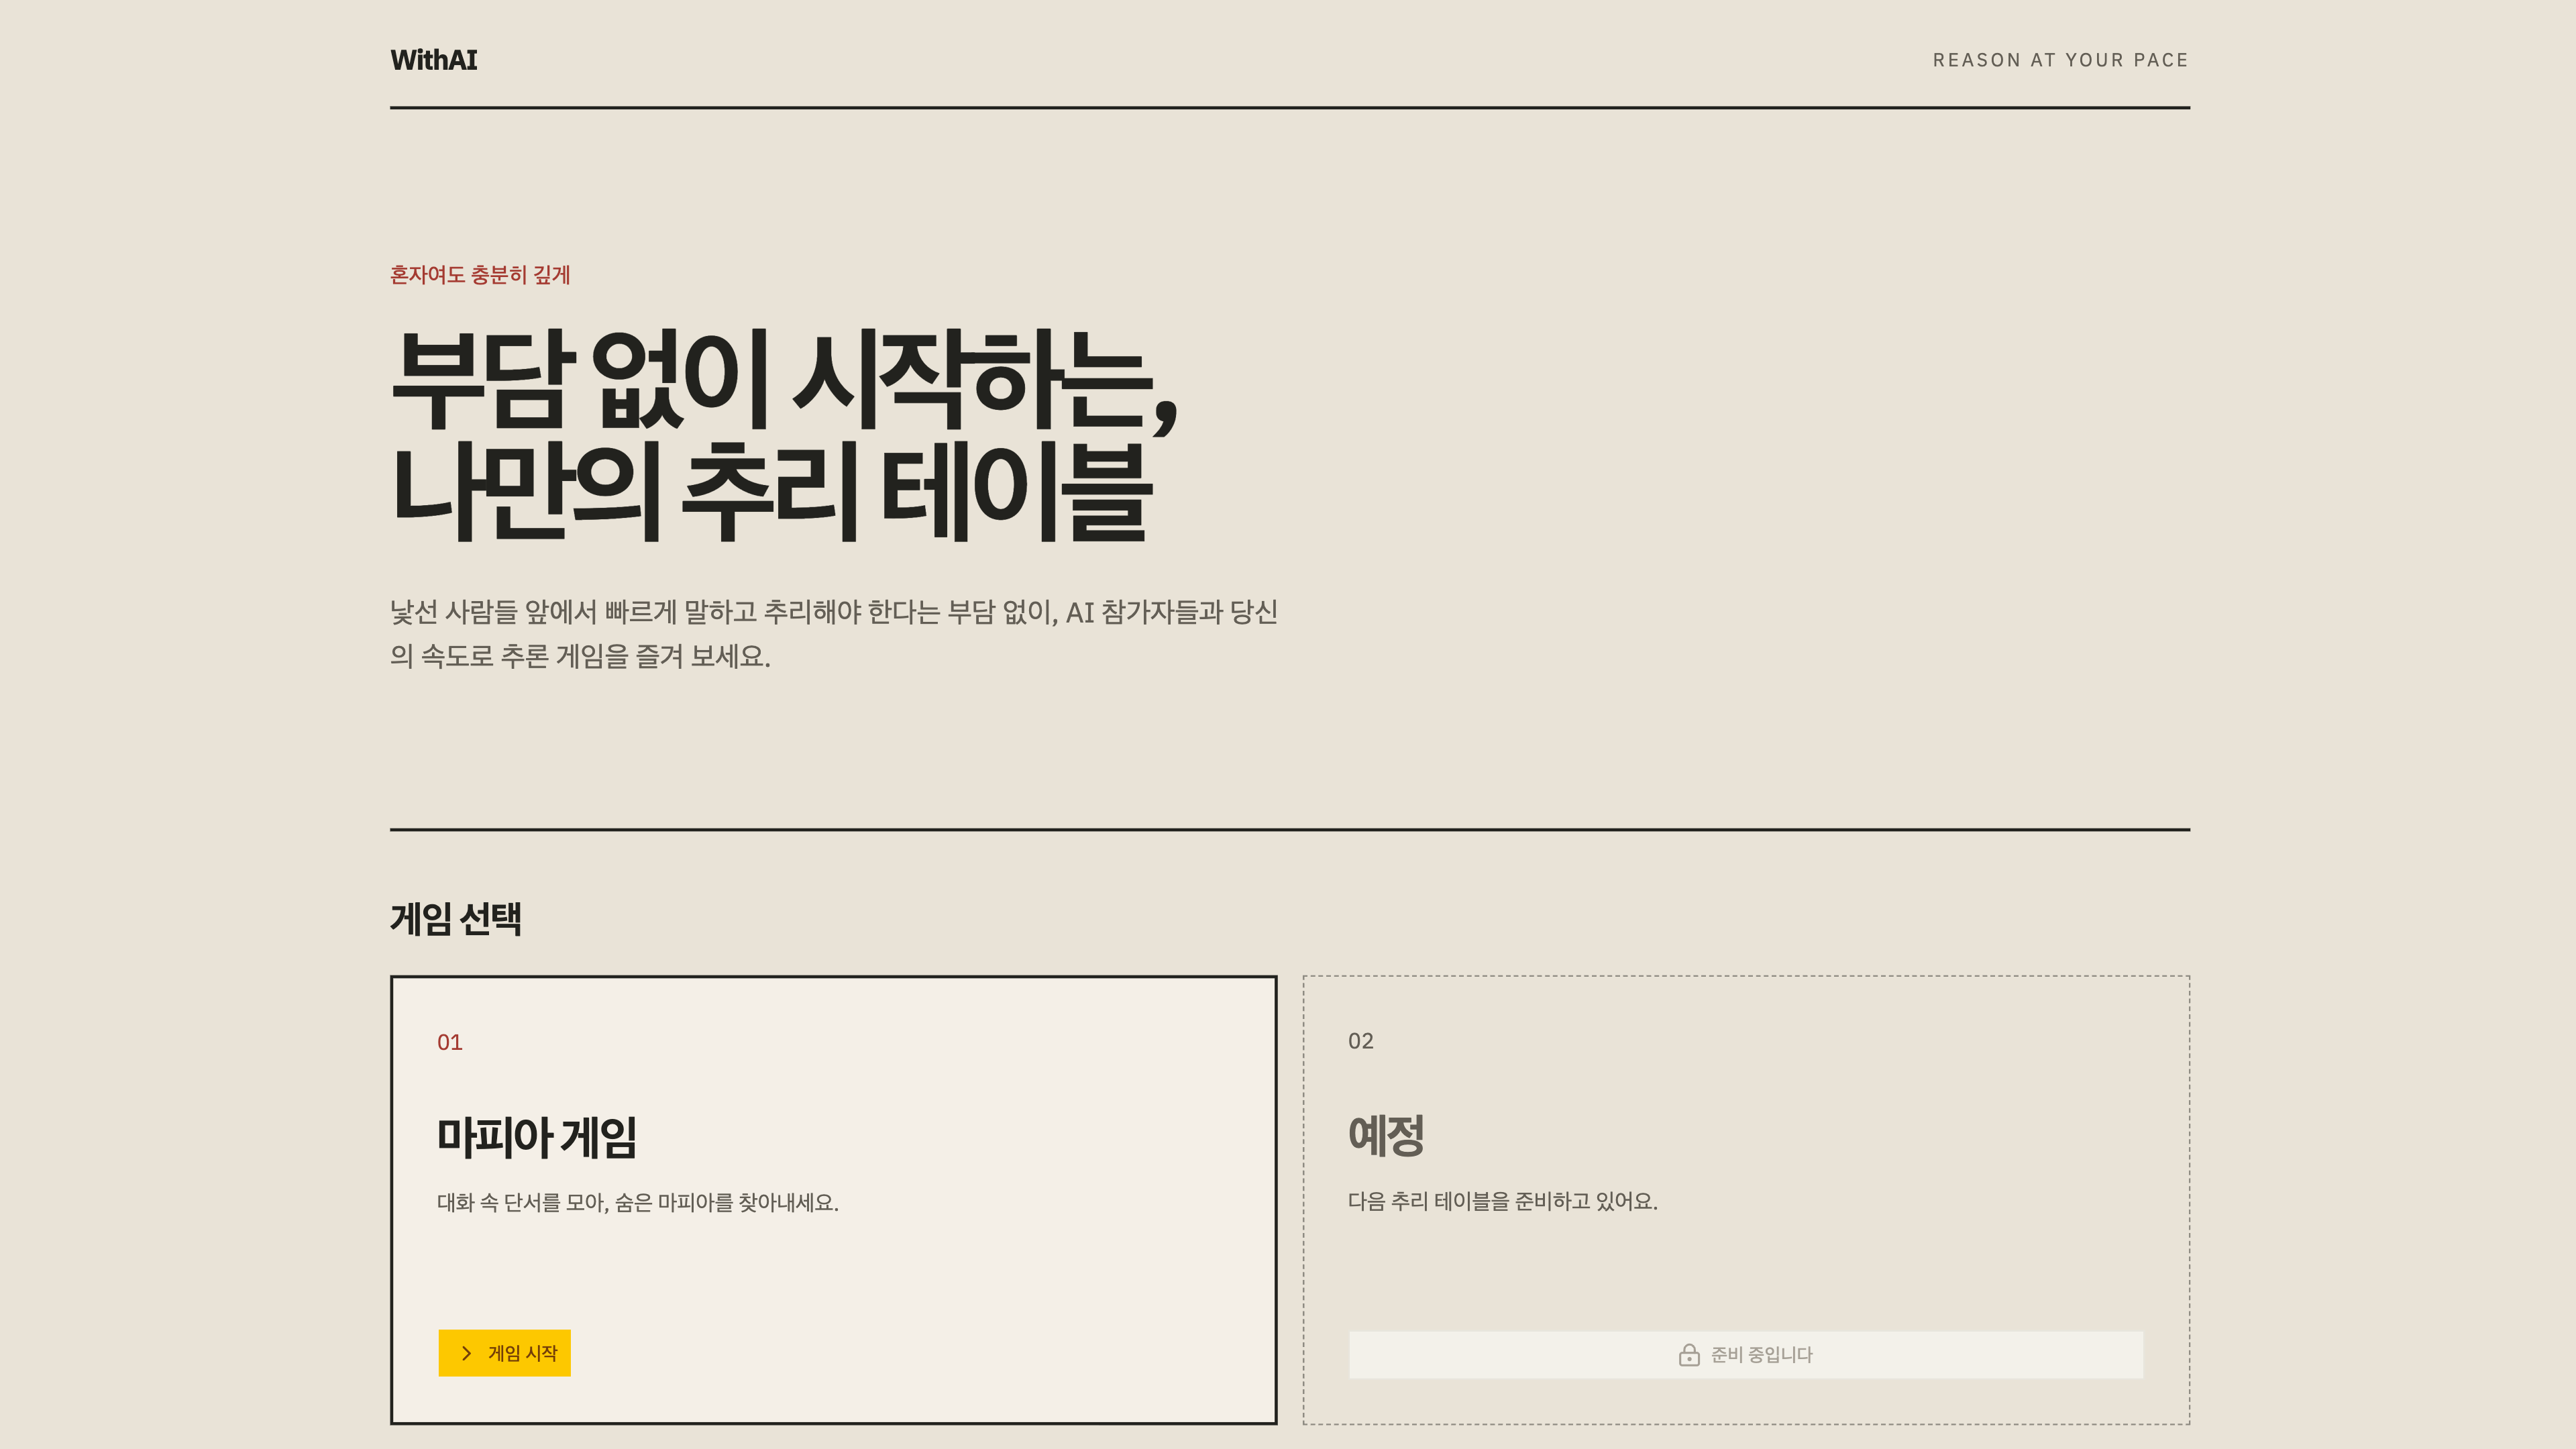
배경 및 목적: 여러 사람과 함께 해야 하는 추론 게임을, 다른 사람으로 인한 부담이나 압박 없이 누구나 혼자서 AI 참가자들과 편하게 즐길 수 있게 하고자 개발하였습니다.
핵심 목표: 독립된 페르소나를 지닌 AI 참가자와의 1인 추론 게임 경험 제공, 게임 규칙 엔진과 플랫폼을 모노레포 내 별도 패키지로 분리하여 다양한 게임으로 확장이 가능한 체계 구축.
2. 담당 역할 및 핵심 기능
담당 역할: 아키텍처 설계/구현을 포함한 프론트엔드 개발 및 에이전트를 활용한 개발 체계 구축 1인 전담
핵심 기능 목록:
반응형 1인 마피아 게임: 낮(자유 토론·시간 조절·투표·변론)과 밤(타겟 선정) 등 실시간 페이즈별 상태에 최적화된 모바일 친화적 입력 컨트롤 제공
실시간 타임라인 및 상태 동기화: HTTP 명령과 SSE 단방향 스트리밍을 결합한 실시간 대화 및 상태 수신
3. LLM 활용 방향 및 범위
프론트엔드/백엔드 모두 기능 구현 시 먼저 LLM과의 질의응답을 통해 세부 기획과 스펙을 엄밀하게 구체화한 후 이를 그대로 코드로 작성하도록 에이전트를 제어하며 생산성 있게 작업하였습니다.
프론트엔드는 에이전트의 초기 작성 후 생성된 모든 코드를 읽고 검토한 후 아키텍처 등 전체적인 설계와 코드를 직접 개선 및 재작성하며 진행하였습니다. 백엔드는 주력인 프론트엔드 아키텍처 및 사용자 경험에 집중하기 위해 스펙 설계 후 빠르게 작성하도록 효율화하였습니다.
사용하는 기술 스택에 관한 에이전트 스킬을 설치하여 에이전트의 구현 능력을 향상시켰으며, 특히 접근성이나 SEO 등 웹 퀄리티를 최적화하기 위해 관련 스킬을 통한 리뷰를 반복하였습니다.
단순 프롬프트 지시 시 컴포넌트가 비대해 지는 등 생성되는 코드 퀄리티에서 반복적으로 나타나는 문제 해결을 위해, 평소 중요하게 생각해왔던 개발 철학과 설계 기준을 규격화해 선언적 타입스크립트 함수형 패턴, 커스텀 훅 기반의 리액트 뷰-로직 분리, UI 트리 아키텍처 리뷰 등의 에이전트 스킬을 작성하여, 에이전트가 고품질 코드를 작성하고 교정할 수 있는 제어 체계를 구축하였습니다.
#
4. 핵심 의사결정 및 문제 해결
1) 비용 최적화와 자연스러운 대화 흐름을 위한 AI 참가자 발화 오케스트레이션 설계
상황 및 과제: 게임 스냅샷이 갱신될 때마다 모든 AI가 발화 결정을 위해 동시에 LLM을 호출하면 API 비용이 과도하게 소모되고, 여러 참가자들이 한 번에 발언을 쏟아내는 등 대화 흐름이 부자연스러운 문제가 발생하였습니다.
기술적 의사결정: 시행착오 끝에 전체 참가자의 API 동시 호출 대신 임의 참가자의 LLM 요청 후 침묵 결정 시 참가자가 다음 호출 후보를 결정하게 하는 라우팅을 적용하기로 결정했습니다.
구현 및 해결: AI 참가자 중 한 명을 무작위로 선택하여 LLM API를 호출하고, LLM 응답에서 발화를 결정하면 즉시 루프를 종료하고 응답 내용으로 스냅샷에 대화를 추가하는 반면 침묵을 결정할 시엔 응답에서 다음 발화 후보를 추천하여 같이 반환하도록 한 후 이 후보로 다음 API 호출을 반복하는 오케스트레이터를 구현하였습니다.
결과 및 영향: 모든 AI 참가자가 API를 호출하던 방식 대비 LLM 요청 횟수를 8인 게임 기준 약 70% 절감해 운영 비용을 최적화하였으며, 실제 사람들이 턴을 주고받으며 토론하듯 자연스러운 타이밍과 밸런스를 갖춘 AI 대화 경험을 달성할 수 있었습니다.
2) UI 트리 아키텍처 리뷰와 뷰-로직 분리를 통한 복잡한 게임 컴포넌트 구조 개선
상황 및 과제: 실시간 게임 특성상 페이즈(토론·지목·변론·투표·밤), 역할, 생존 여부에 따른 수많은 상태와 조건부 분기 로직이 컴포넌트 내부에 직접 뒤섞여 코드 복잡도가 치솟고 유지보수가 어려운 문제를 체감하였습니다.
기술적 의사결정: 직접 제작한 에이전트 스킬(뷰-로직 분리 및 UI 트리 리뷰)을 적용하여, UI 렌더링 계층에서 상호작용 로직을 순수 함수로 분리하는 구조를 도입하기로 결정하였습니다.
구현 및 해결: ts-pattern 기반으로 게임 스냅샷과 상태를 페이즈별 유니온으로 변환하는 함수를 작성하고, 하위 패널 및 선택 컴포넌트들이 이를 참조해 선언적으로 사용하도록 컴포넌트 계층을 전면 재구조화하는 방향으로 코드를 개선하였습니다.
결과 및 영향: 컴포넌트 내 난잡했던 명령형 분기 코드를 완전히 걷어내어 UI 구조를 직관적으로 개선하였으며, 리액트 렌더링과 독립된 단위 테스트 환경에서 모든 페이즈별 상호작용을 안전하게 검증할 수 있게 되었습니다.
3) 사용자 의도 예측형 프리페치와 컴포넌트 지연 로딩을 통한 진입 UX 최적화
상황 및 과제: 메인 페이지 로딩 시 번들 크기를 줄이기 위해 게임 시작 다이얼로그 컴포넌트를 코드 스플리팅 및 지연 로딩하였으나, 사용자가 '게임 시작' 버튼을 누르는 순간 JS 청크 다운로드와 잔여 플레이 가능 횟수 API 조회가 발생하여 모달 오픈에 체감 지연이 생기는 것을 발견하였습니다.
기술적 의사결정: 단순 React.lazy 분할에 그치지 않고, 사용자 마우스 이동 궤적을 감지하여 클릭 의도를 사전에 예측하는 ForesightJS 기반의 예측형 프리페칭과 전용 스켈레톤 UI를 결합하기로 결정했습니다.
구현 및 해결: 버튼 접근 시 다이얼로그 컴포넌트 청크와 TanStack Query 게스트 권한 데이터를 병렬로 사전 로딩하고, Suspense 폴백으로 모달 스켈레톤을 배치하였습니다.
결과 및 영향: 메인 페이지의 JS 번들 크기를 10%(19KB) 경량화하여 LCP를 1.15s에서 0.95s로, 버튼 클릭 시의 다이얼로그 오픈 INP를 112ms에서 64ms로 단축해 보다 쾌적한 진입 경험을 완성하였습니다.
5. 주요 성과
실시간 스트리밍(SSE), 페이즈 전환, 타이머, 유저 입력이 공존하는 복잡한 상태를 뷰-로직 분리로 구조화하여, 매끄러운 1인 추론 게임을 완성
폰트 레이아웃 시프트 방지, 프리페치를 활용한 다이얼로그 지연 로딩, 접근성 및 반응형 UI 최적화 등을 통해 다양한 기기의 웹 브라우저에서도 쾌적한 사용자 경험 제공
원티드 AI Championship 2026에 참가하여 완성된 프로젝트의 성공적 공유
Jaspr Portfolio
2024
Dart 기반 웹 프레임워크인 Jaspr로 개발한 개인 포트폴리오 홈페이지
#Dart
#Jaspr
#Riverpod
#Tailwind CSS
#Melos
#Docker
#AI Agent
1. 프로젝트 개요
배경 및 목적: 기존 Flutter Web의 큰 초기 번들 사이즈와 SEO 취약점을 극복하면서, Dart 생태계의 컴포넌트 모델과 상태 관리 체계를 그대로 활용할 수 있는 현대적인 반응형 포트폴리오 웹사이트를 구축하고자 시작하였습니다.
핵심 목표: 순수 HTML/CSS 렌더링을 통한 가벼운 웹 성능 확보, 콘텐츠 유지보수를 최소화하는 데이터 주도 구조 설계, 그리고 AI 피드백 체계 통합.
2. 담당 역할 및 핵심 기능
담당 역할: Melos 기반 모노레포 아키텍처 설계, Jaspr 컴포넌트 개발, 반응형 UI/UX 구현, AI 에이전트 하네스 구축 등 전체 1인 전담 개발
핵심 기능 목록:
반응형 포트폴리오 & 이력서 뷰어: 모바일 및 데스크톱 뷰포트에 최적화된 프로젝트/경력 정보 UI
Configuration Driven Development (CDD): 마크다운 및 YAML 데이터 기반 정적 콘텐츠 자동 파싱 및 렌더링
AI 에이전트 이력서 하네스 구축: Antigravity 기반 개발자 이력서 피드백을 지원하는 하네스 구축
3. LLM 활용 방향 및 범위
처음 프로젝트를 수행할 때는 아직 LLM 초창기라 활용에 신중했기에 사용하지 않고 개발하였으나, 이후 기술 발전으로 효용성이 충분해졌다 판단해 유지보수 등을 시작으로 점진적으로 LLM을 통한 코드 작성을 시도하였습니다.
Dart, Jaspr, Web 등 다양한 도메인에 에이전트 스킬을 설치하고, 이를 통한 전반적인 코드 및 아키텍처의 개선 작업을 진행하였습니다.
이력서의 관리 및 웹 서빙이란 프로젝트의 본 목적을 넘어 서브에이전트와 스킬 등에 기반한 하네스를 작성해 저장된 이력서 내용을 LLM 피드백 및 수정하는 플로우를 구축하였습니다.
4. 핵심 의사결정 및 문제 해결
1) Flutter Web 대신 Jaspr 웹 프레임워크 도입
상황 및 과제: Dart/Flutter 개발 경험을 살리면서도 일반 웹 사용자에게 빠른 초기 로딩 속도와 SEO를 제공해야 했습니다.
기술적 의사결정: Flutter Web은 Canvas/Wasm 기반으로 렌더링되어 번들 사이즈가 크고 SEO에 제약이 있는 반면, Jaspr는 Dart 언어를 사용하면서도 브라우저 표준 HTML/CSS를 직접 출력하는 SSR/SSG을 지원하여 웹 표준과 생산성을 동시에 만족했습니다.
구현 및 해결: Jaspr를 도입하고 Tailwind CSS를 결합하여 스타일링 시스템을 구축하였으며, Riverpod을 통해 상태를 모듈화하였습니다.
결과 및 영향: 기존 Flutter Web의 한계를 극복하여, 번들 크기를 경량화하고 순수 시맨틱 HTML/CSS 기반의 빠른 렌더링과 뛰어난 검색 엔진 최적화(SEO)를 달성했습니다.
2) Configuration Driven Development (CDD) 아키텍처 설계
상황 및 과제: 새로운 프로젝트나 경력 이력이 추가될 때마다 파편화된 Dart 컴포넌트 코드를 직접 수정해야 하는 비효율을 제거하고 싶었습니다.
기술적 의사결정: 데이터와 코드를 엄격히 분리하여, 마크다운과 YAML 설정 파일만 업데이트하면 빌드 타임에 자동으로 적용되는 구조를 설계했습니다.
구현 및 해결: content 디렉토리에 프로젝트 및 이력서 콘텐츠를 파일 단위로 배치하고, dart_mappable과 마크다운 렌더러 컴포넌트를 통해 메타데이터와 본문을 동적으로 결합하도록 구성했습니다.
결과 및 영향: 새로운 경력이나 프로젝트가 추가될 때마다 Dart 코드를 직접 수정하던 비효율을 제거하고, 마크다운/YAML 파일 수정만으로 빌드 타임에 자동 반영되는 유지보수성 높은 데이터 주도 환경을 구축했습니다.
5. 주요 성과
Melos 기반의 패키지 단위 관심사 분리로 기능별 코드 의존성 격리 및 개발 생산성 확보
CDD 기반 확장성 있는 반응형 웹 포트폴리오 완성 및 Docker 기반 배포 환경 구축
Antigravity 에이전트 플러그인과 결합하여 피드백을 통한 개발자 이력서 개선 플로우 확립
CoAI @ 몰입캠프
2024
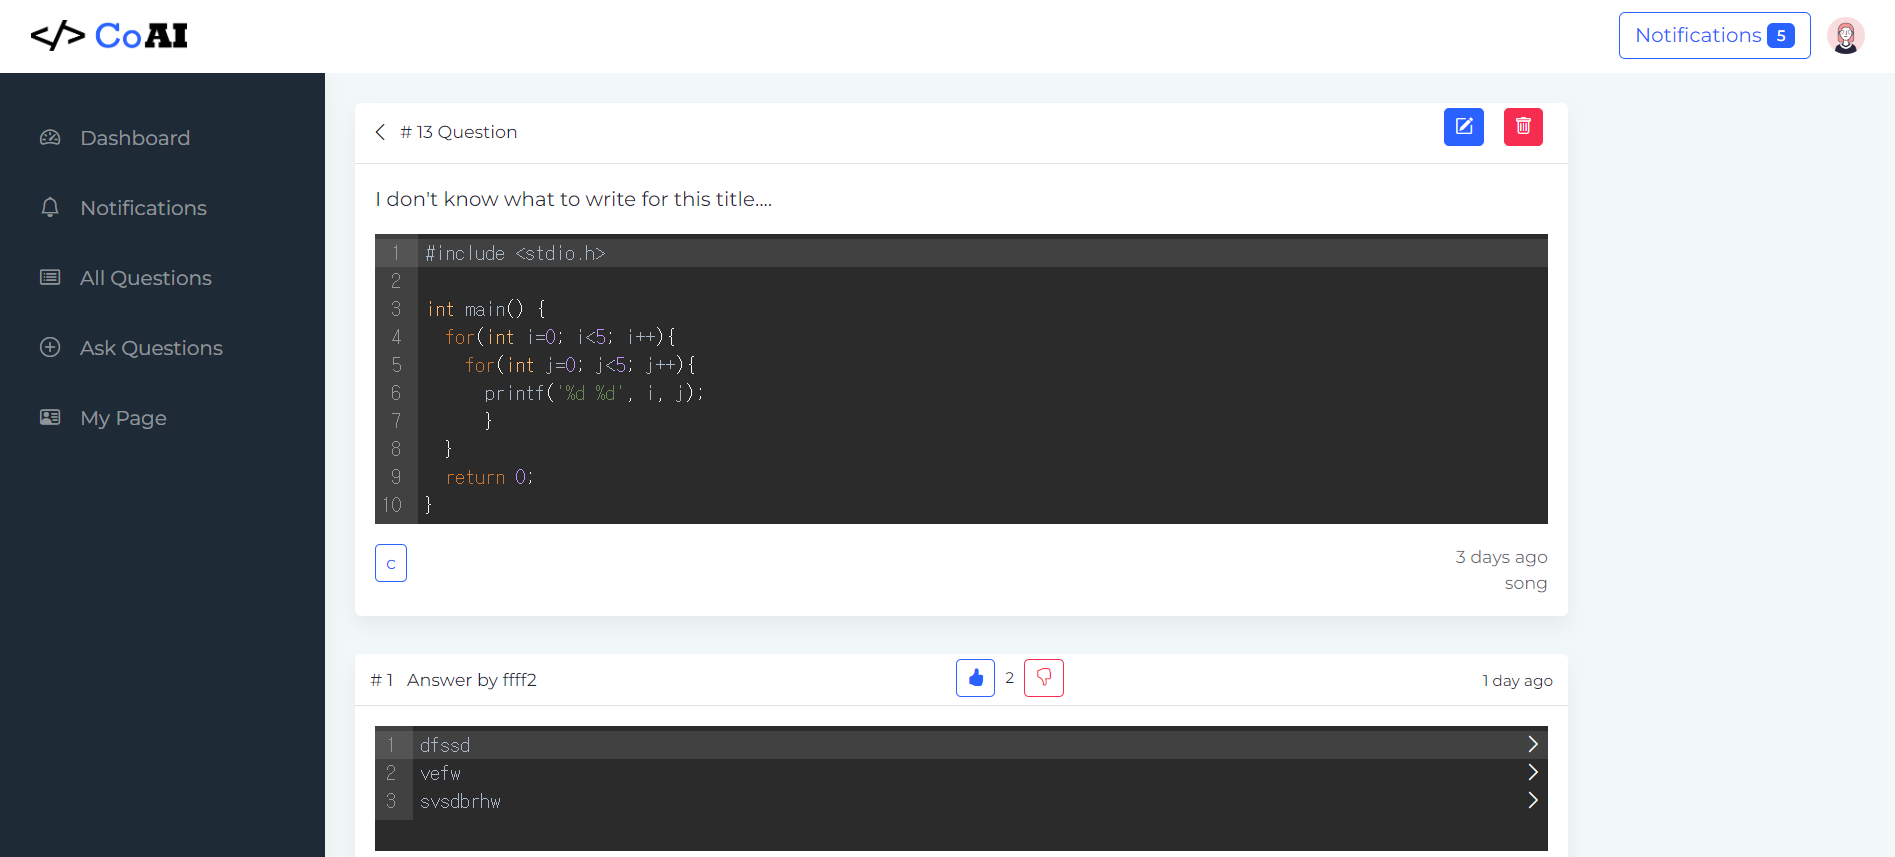
개발자들이 질문을 하고 지식을 공유할 수 있는 AI 플랫폼
#HTML
#CSS
#JavaScript
#React
#TypeScript
#Express
#PostgreSQL
#Drizzle ORM
#LangChain
1. 프로젝트 개요
배경 및 목적: KAIST 몰입캠프 4주차 프로젝트로, 개발자 간의 코드 질의응답뿐만 아니라 생성형 AI(GPT)가 답변을 작성해주는 Q&A 플랫폼을 구축하고자 기획되었습니다.
핵심 목표: 사용자가 질문을 등록할 때 LLM이 생성하는 답변을 지연 없이 실시간 스트리밍으로 프론트엔드 UI에 전달하고, 생성된 답변을 누락 없이 데이터베이스에 저장하는 백엔드 파이프라인 구축.
2. 담당 역할 및 핵심 기능
담당 역할: 백엔드 REST API 설계 및 Swagger를 통한 프론트엔드와의 협업 체계 구축, PostgreSQL 스키마 및 Drizzle ORM 모델링, LangChain 연동 및 스트리밍 파이프라인 전담, LLM 답변 스트리밍 프론트엔드 UI 구현 (팀원은 그 외 프론드엔드 전담)
핵심 기능 목록:
게시글 및 질의응답 CRUD API: 개발자 질문, 답변, 댓글 등을 관리하는 API 엔드포인트
타입 안전한 데이터 관리: Drizzle ORM 기반의 스키마 마이그레이션 및 타입 세이프 쿼리 빌딩
GPT 연동 실시간 스트리밍 AI 답변: 새 질문 작성 시 LangChain을 통해 GPT 모델과 연동되어 프론트엔드 UI로 실시간 스트리밍되는 답변 제공
3. LLM 활용 방향 및 범위
서비스 자체는 LangChain 및 OpenAI API를 연동하는 플랫폼이었으나, 프로젝트 수행 당시는 LLM 초창기였기에 코드 작성 및 설계는 LLM 활용 없이 직접 진행하였습니다.
4. 핵심 의사결정 및 문제 해결
1) Node.js Transform 기반 스트림 처리 파이프라인 설계
상황 및 과제: LangChain을 통해 OpenAI로부터 들어오는 실시간 텍스트 청크를 기존 응답 DTO 내용과 함께 클라이언트에 즉각 전송해야 함과 동시에, 생성이 완료된 전체 답변 본문을 데이터베이스에 저장하여 클라이언트에서 새로고침 후에도 휘발되지 않도록 해야했습니다. 전체 LLM 텍스트를 모두 수신하고 나서야 응답 DTO를 작성하고 클라이언트로 전송하는 방식은 UX 상 부적절하다 판단했습니다.
기술적 의사결정: 리서치 후 청크 전송 인코딩을 사용하여 응답을 보내며, Node.js의 Transform 스트림을 활용하여 단일 스트림 내에서 기존 응답 내용 및 청크의 클라이언트 전송과 청크 텍스트 병합을 동시에 처리하는 파이프라인을 구상했습니다.
구현 및 해결: Transform 클래스의 인스턴스를 생성하여 먼저 생성자에서 일반 응답 DTO를 stringify하여 스트림으로 푸시하고, LangChain 응답 스트림으로부터 유입되는 청크를
transform 메소드에서 다시 푸시하면서 선언해둔 문자열 변수에 이를 병합한 후 스트림이 종료되는 시점에 완성된 문자열을 데이터베이스에 저장하도록 구현했습니다.
결과 및 영향: 프론트엔드에서 응답 스트림을 가져와 즉각적으로 렌더링하는 스트리밍 UI 컴포넌트를 구현하였으며, 서버 측에서는 데이터 유실 없이 데이터베이스에 답변이 적재되는 파이프라인을 완성했습니다.
5. 주요 성과
1주일이라는 짧은 기간 내에 백엔드 전체 아키텍처 및 LLM 스트리밍 연동 파이프라인을 안정적으로 구현 완료
캠프 최종 데모 시연에서 실시간 AI 답변 생성을 포함한 서비스 전체 기능 오류 없이 성공적 시연